玩过奥奇传说、赛尔号、奥拉星这类 Flash 页游的人,大概都有过这几种体验:
- 放个大招,卡一下;
- 开个界面,转半天圈;
- 玩上一两个小时,越玩越卡;
- 要是再点一下全屏,直接变幻灯片。
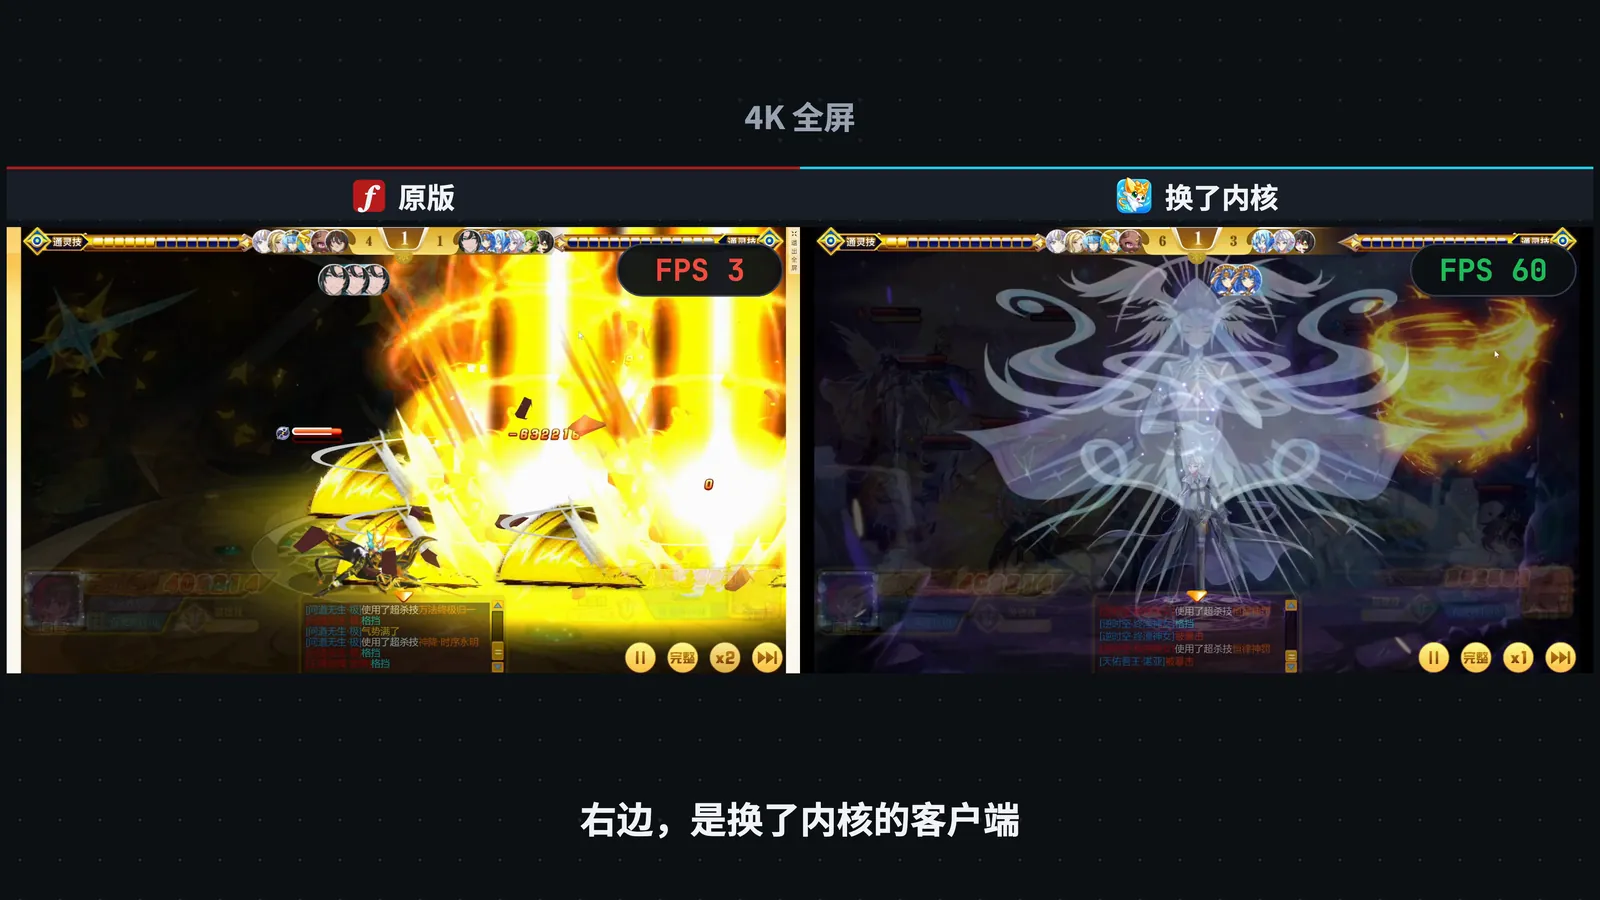
上图是同一台电脑(i7-11850H + RTX 2080 Ti)、同一场战斗。游戏是同一个游戏,差距到底从哪来?这段时间我给奥奇传说做了一个基于 Ruffle 的桌面客户端,顺手把 Flash Player 拆开、一帧一帧地看了一遍。这篇文章把过程整理出来,配图来自我为此做的一期科普视频。
先说结论:Flash 页游卡,不是算不动,是画不动。
一、Flash Player 是怎么跑一个游戏的
SWF:一卷胶片,外加一本剧本
Flash 游戏的一切都装在 SWF 文件里。它不像一堆图片,更像一卷胶片外加一本剧本:
- 形状:角色、按钮、特效大多是矢量图形,存的不是像素,而是"移动到 (120, 40)、画曲线到 (220, 90)、用 #FF8800 填充"这样的绘图指令,所以 Flash 的画面放多大都不会糊;
- 位图、声音、字体等资源;
- 脚本:游戏逻辑用 ActionScript 3 写成,编译成 AVM2 字节码,也装在里面;
- 时间轴:每一帧往舞台上放什么、拿走什么。
像奥奇这样的大型页游,会拆成成百上千个 SWF,玩到哪下载到哪。
一台只有一条传送带的机器
我把 Flash Player 画成一台机器,里面有几个工位:
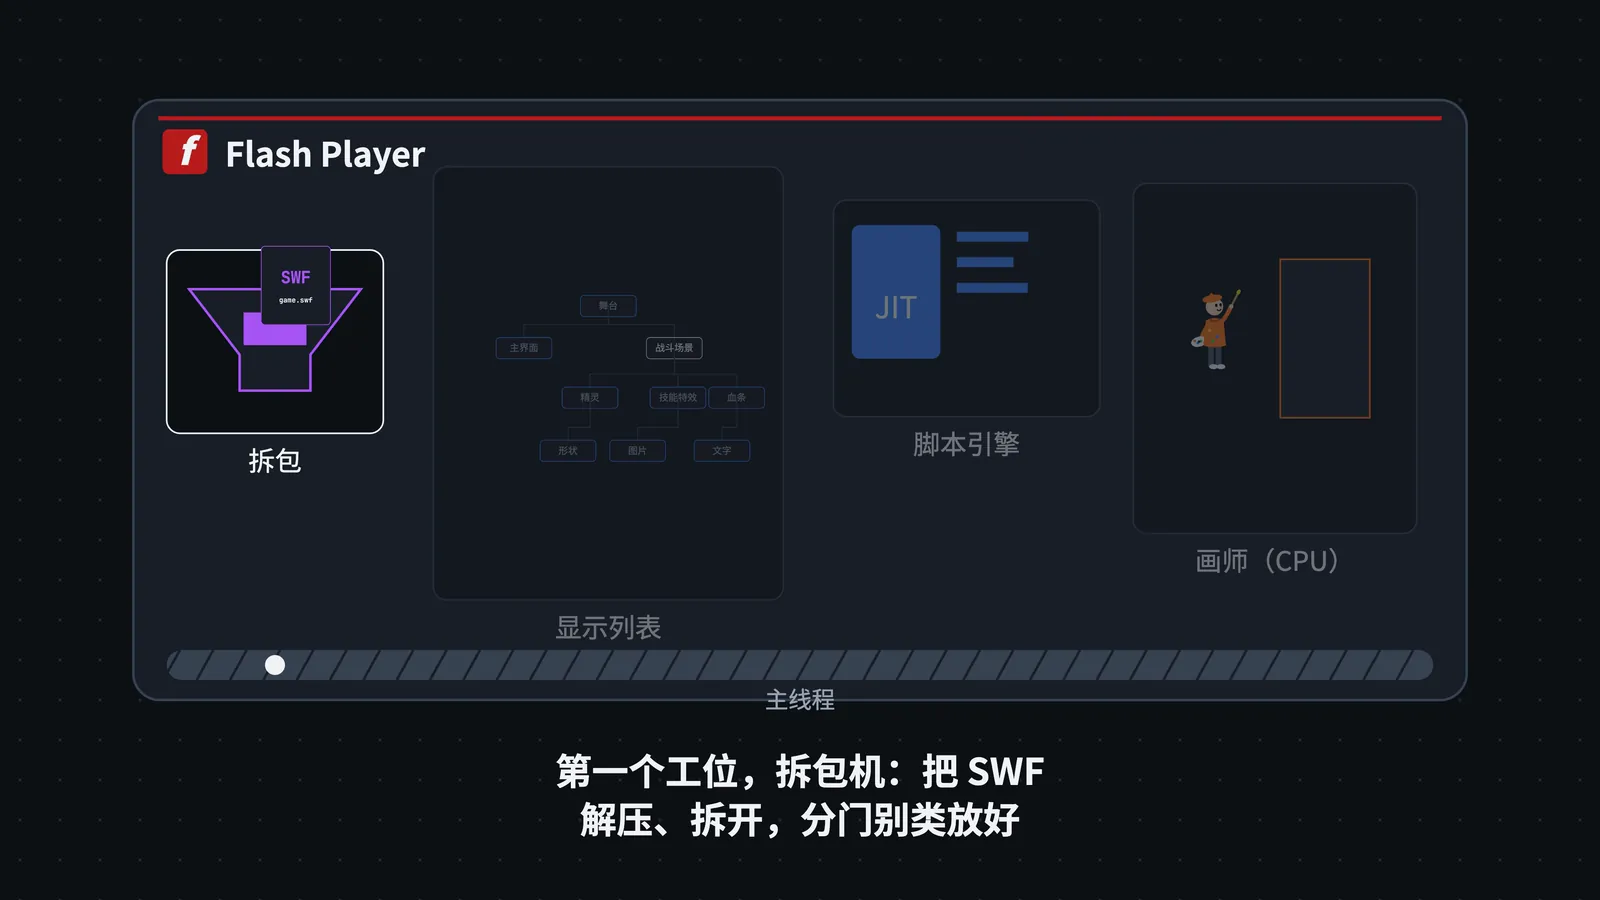
- 拆包:把 SWF 解压、解析,分门别类放好;
- 显示列表:一棵树。舞台是树根,界面、精灵、特效一层层挂在上面,屏幕上的每样东西都是树上的一个节点;
- 脚本引擎:AVM2 虚拟机,带 JIT,会把字节码现场翻译成机器码。所以 Flash 跑游戏逻辑其实一点都不慢,记住这句话;
- 画师:负责把画面画出来,整台机器里最忙的人;
- 还有一个垃圾回收器,负责清理不再使用的内存。
最关键的是,这几个工位之间只有一条传送带,叫主线程。谁在用它,其他人就得等着。
弹性跑道:16.7 毫秒的一圈
Flash 的每一帧就像在跑道上跑一圈:处理鼠标、网络、计时器这些事件,执行每帧代码,推进时间轴动画,最后把画面画出来,剩下的时间空着等下一圈。想要 60 帧,这一圈就要在 16.7 毫秒内跑完。
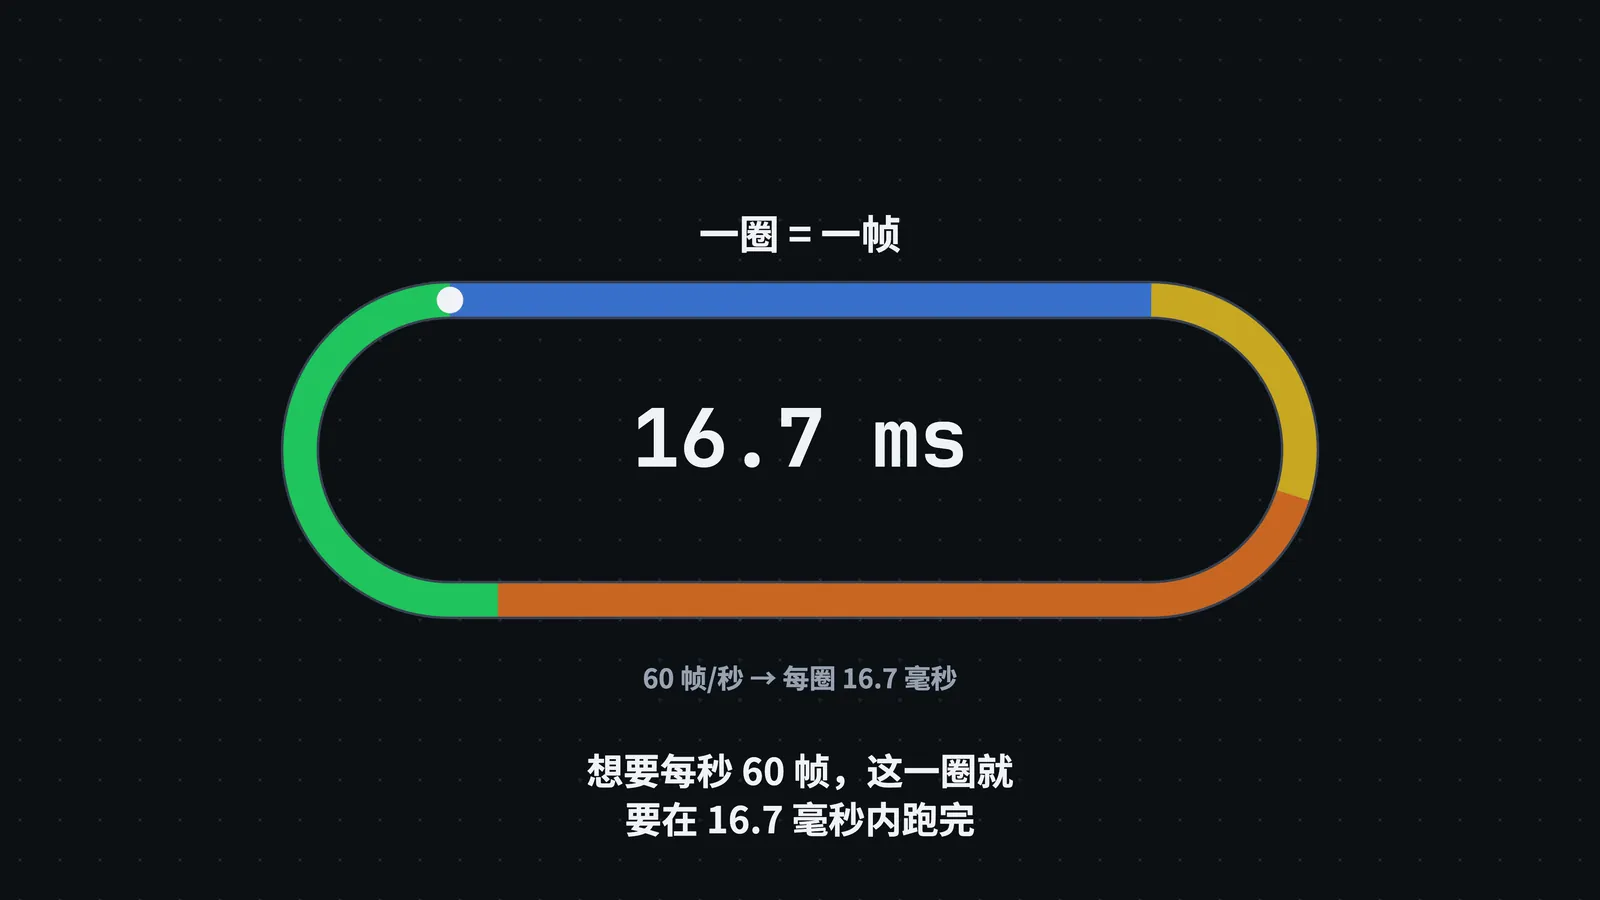
问题是这些活全挤在同一条主线程上,一个接一个。任何一段干得太久,整圈就被撑长,帧率就掉了。Flash 开发者管这个叫"弹性跑道"(elastic racetrack)。
那在奥奇里,被撑长的通常是哪一段?
画师是怎么画画的
Flash 的传统显示列表全靠 CPU 软件光栅化:
- 找出这一帧有变化的区域(脏矩形);
- 对区域里的每个形状一行一行地扫过去,判断每个像素有没有被盖住,算出颜色;
- 为了边缘平滑,高画质下边缘的每个像素还要切成 4×4、16 个小格子,一格一格地判断覆盖率;
- 最后把所有图层叠起来,送到屏幕上。
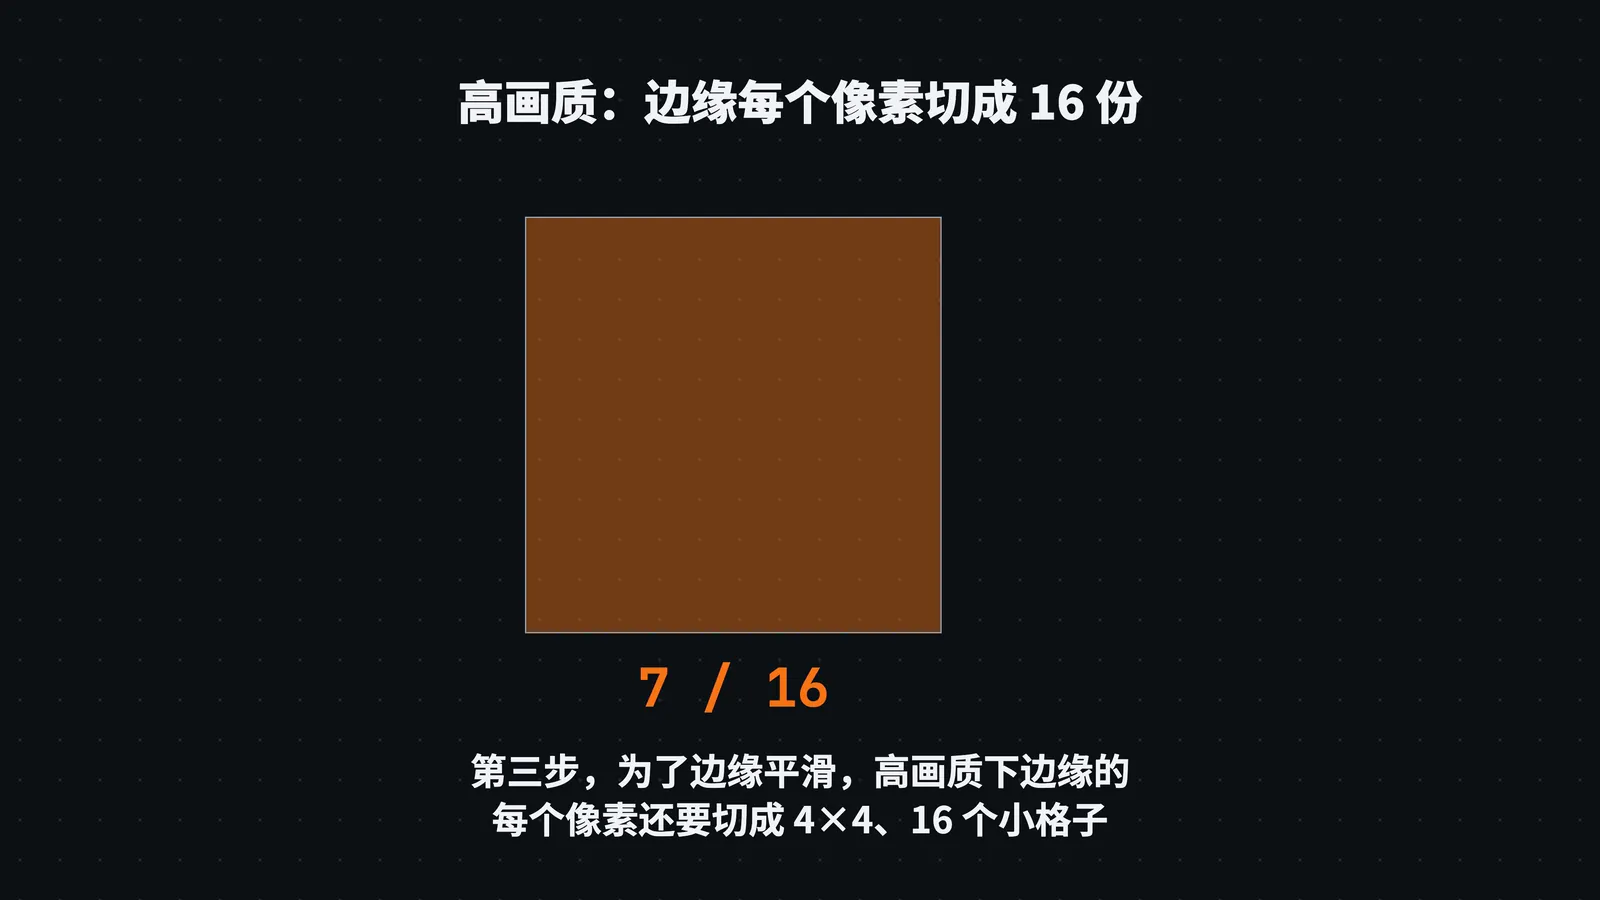
后来的 Flash 能让几个 CPU 核心一起画,可说到底还是 CPU。Flash 也出过能调用显卡的 Stage3D,但游戏得把整个画面层重写一遍——奥奇传说、赛尔号、奥拉星这些到今天还在运营的页游,用的都还是传统显示列表。
特效:动一下,整套重来
再看滤镜。给对象加一个发光(GlowFilter),Flash 要:
- 先把对象画成一张位图;
- 复制一份做模糊,横着扫一遍、竖着扫一遍;
- 染色;
- 叠回原图。
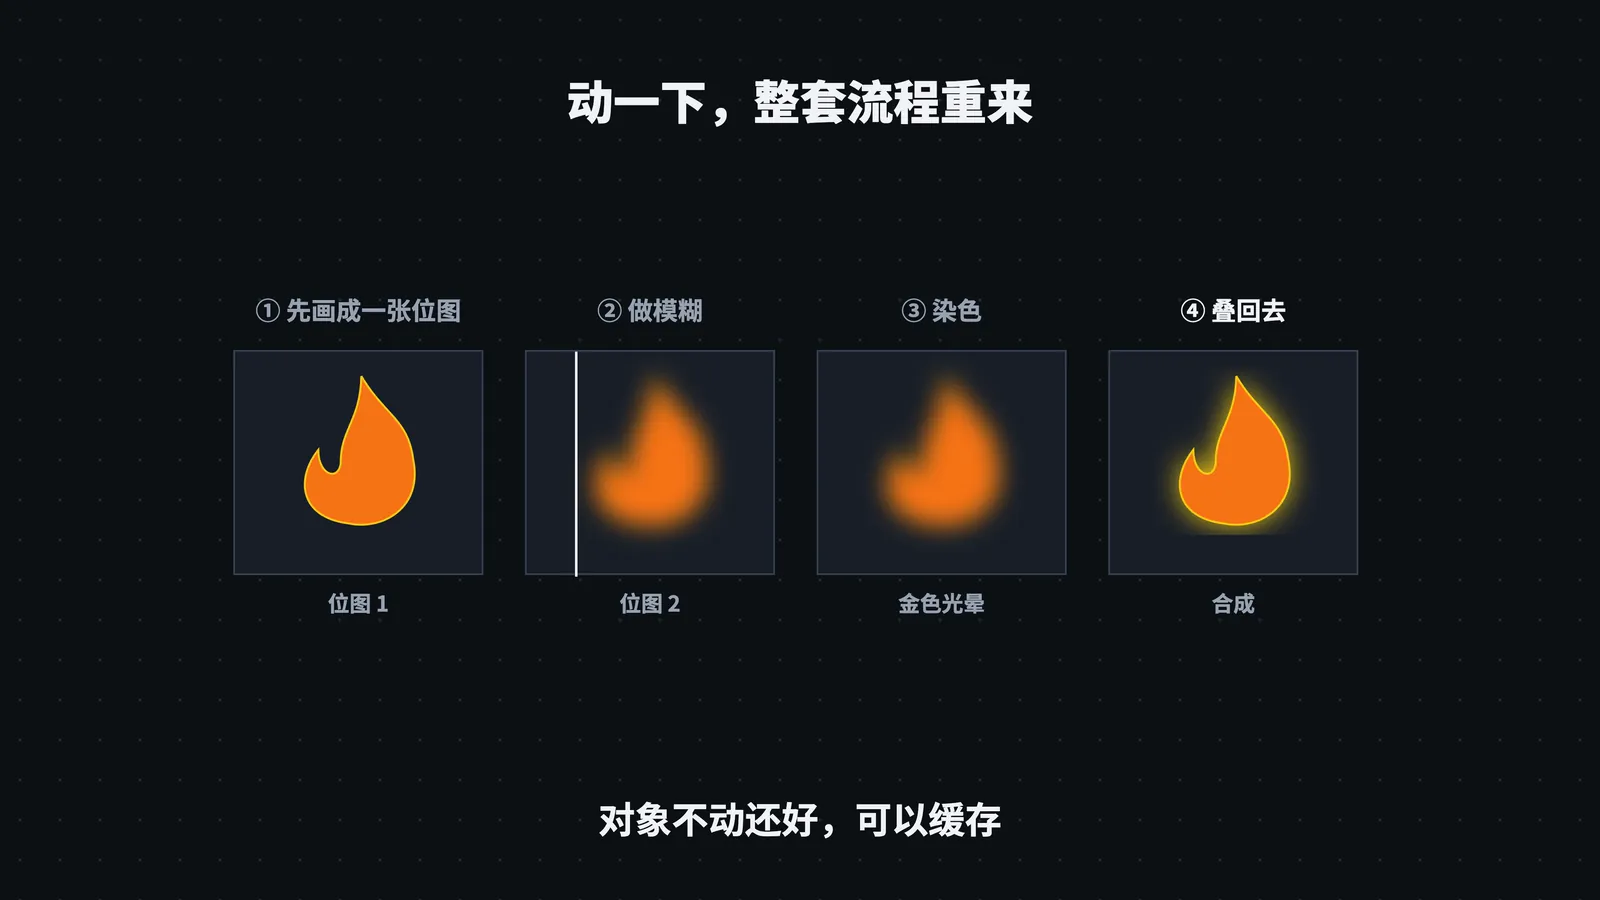
对象不动时可以缓存。可战斗特效全是动的:动一下整套流程就得重来一遍,一秒钟六十遍。
二、为什么会卡
为了看清楚,我给录屏叠了一个"透视窗":右边是帧率和 CPU、显卡占用,下面每根柱子是一帧,越高越慢,超过虚线就是掉帧。
卡顿一:大招
窗口模式下的普通战斗还算流畅,大招一放就卡。把卡住的那一帧拆开:脚本只占几毫秒,几乎全部时间都花在了渲染上。
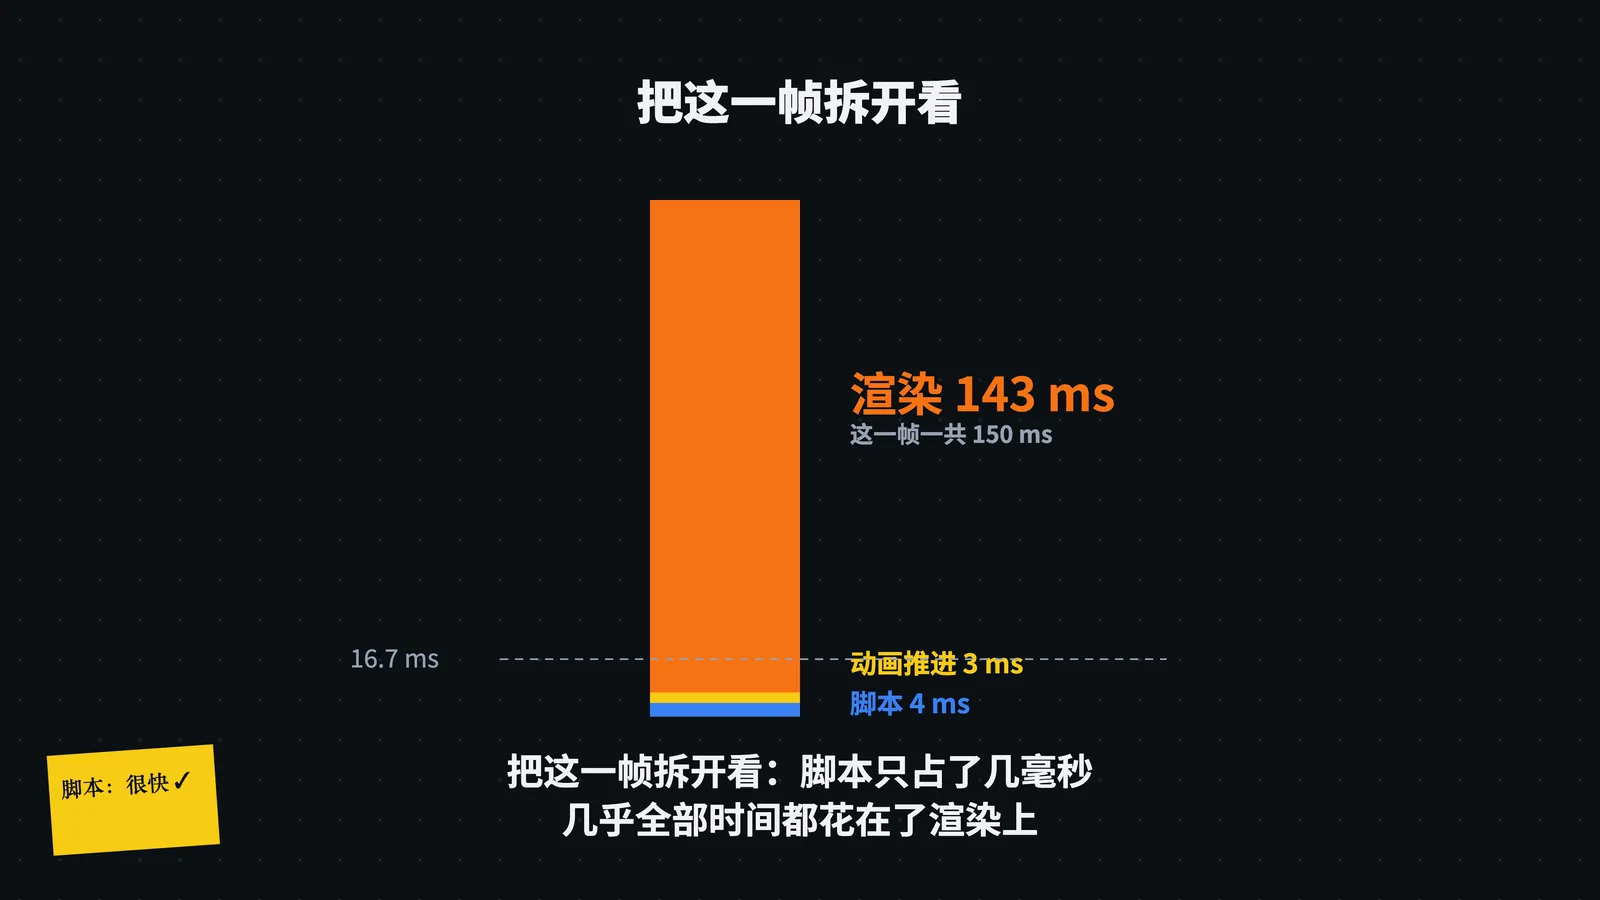
这一瞬间满屏都在动,重绘区域直接变成整个屏幕。我数过奥奇的一个战斗画面,同时挂着一百二十多个带发光滤镜的对象。每一个都要画位图、做模糊、叠回去,每一帧都要重来,全压在那几个 CPU 核心上。显卡呢?还在睡。
卡顿二:分辨率
那把窗口放大呢?窗口越大越卡,到了 4K 全屏,平时就快动不了。

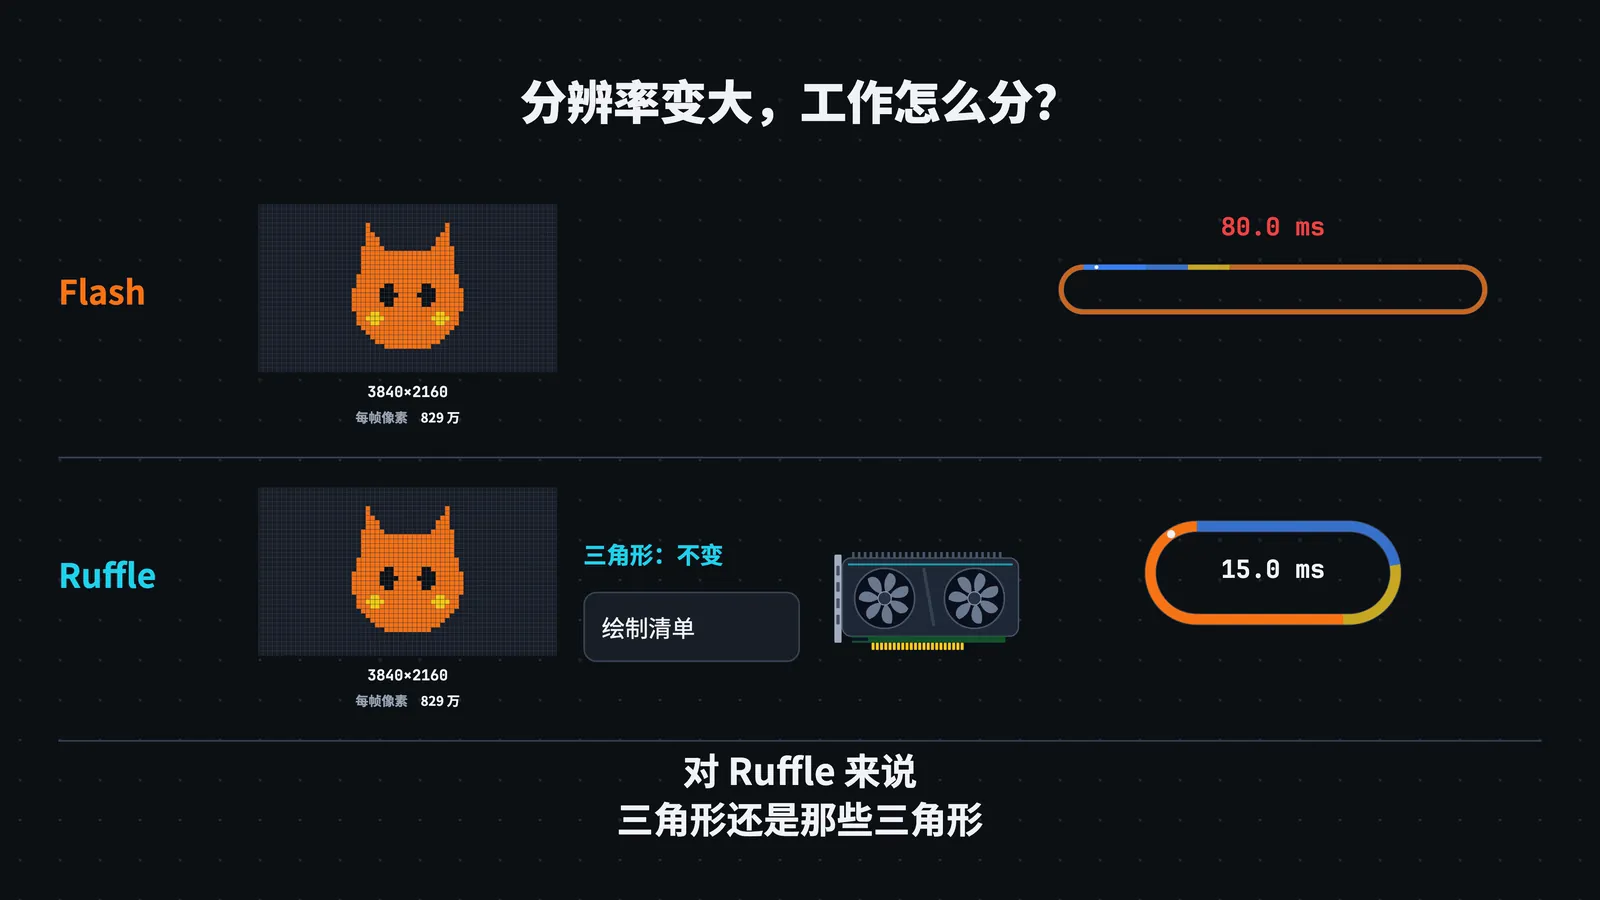
原因很简单:游戏逻辑没变,变的是要画的像素。从默认的 960×560 到 3840×2160,一帧要画的像素翻了 15 倍,每个滤镜的中间位图也跟着一起变大。脚本那一段纹丝不动,被撑爆的只有渲染。
卡顿三:加载
开界面、进战斗时的卡顿是另一回事。下载本身在后台,可文件一到,解压、解析、初始化这些活都要回到主线程上一口气做完。一个大模块就能占住几百毫秒,这段时间里画面没人画。进一次战斗要加载几十个这样的模块。
卡顿四:越玩越卡
挂机一两个小时以后,就算没有特效也会隔一会儿顿一下。玩得越久,内存里堆的东西越多;有些东西本该清掉,却还被某段代码"拴着"(事件监听、静态字典、没卸载干净的 Loader)。内存一满,垃圾回收器就得进场把所有东西检查一遍,检查的时候全场停工,堆越大停得越久。
四种卡顿放在一起看:撑长跑道的是渲染、加载、垃圾回收,真正算游戏逻辑的那一段一直都很短。电脑的显卡越来越强,屏幕越来越大,可 Flash 用不上显卡——画面越大,它就越卡。而 2020 年底 Adobe 停止支持 Flash 之后,这些问题再也不会被修了。
三、Ruffle:换一种画法
Flash 停更以后,一群开发者用 Rust 把 Flash Player 从头重写了一遍,这就是 Ruffle。它完全开源,互联网档案馆就用它保存了大量老 Flash 作品。它读的是同样的 SWF,跑的是同样的字节码,但画画的工位完全不同。
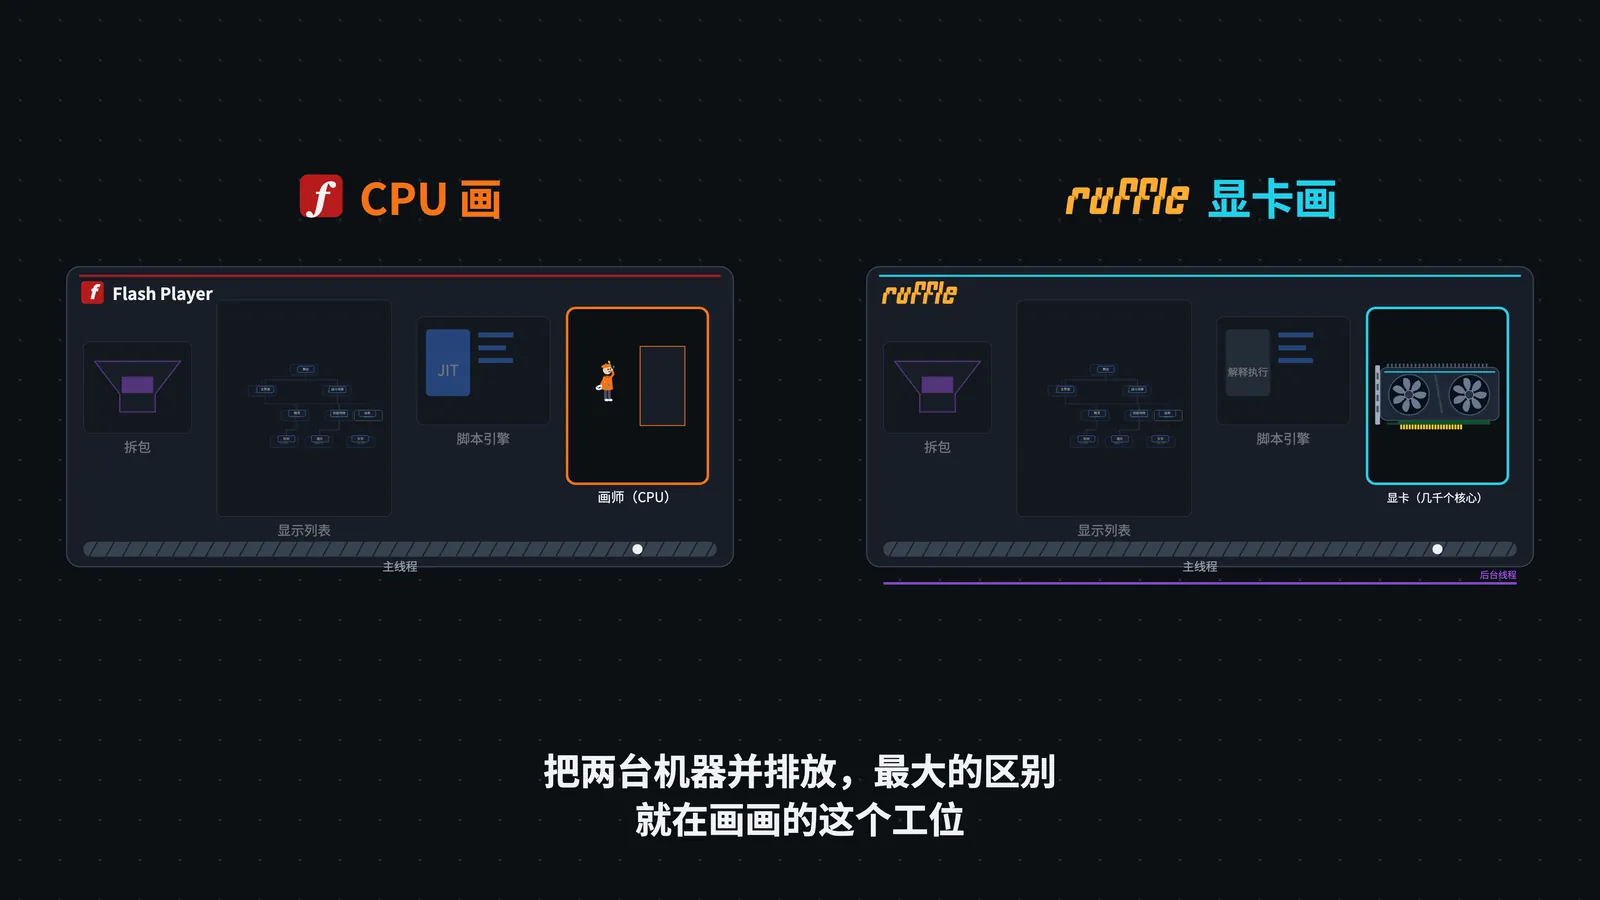
三角形 + 矩阵
Ruffle 拿到一个矢量形状,不是逐像素扫描,而是先把它三角化,切成一堆小三角形,上传到显存。同一个形状在画面上出现十次,十次共用这一份网格。
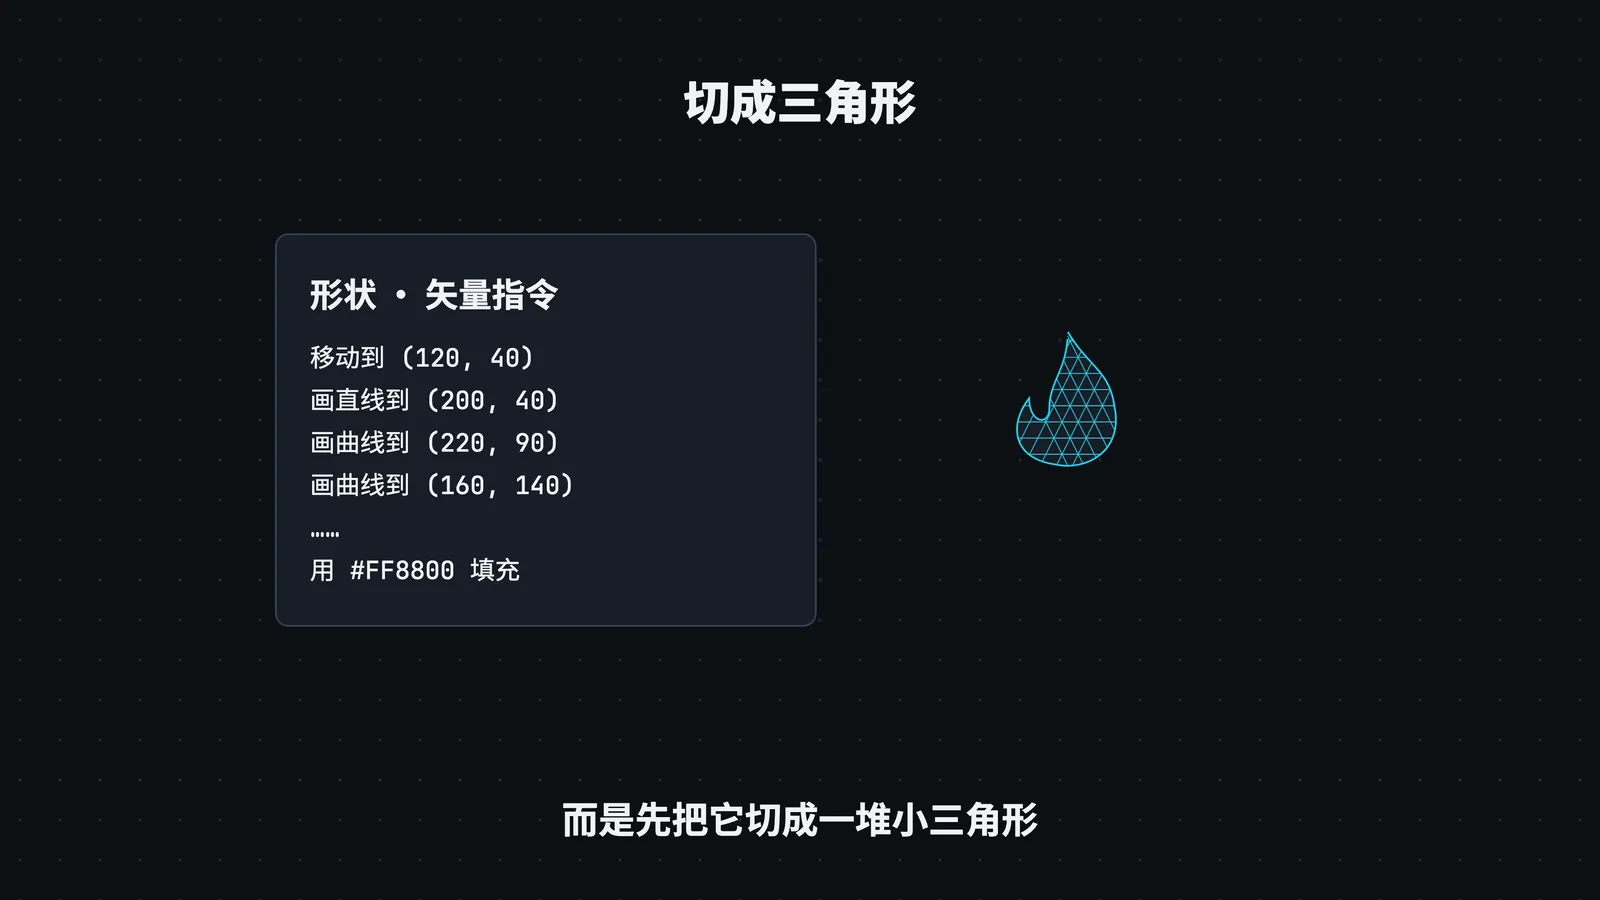
之后它移动、旋转、缩放都不用重新三角化,只要给显卡一个新的变换矩阵。真正填像素的活交给显卡里几千个核心并行完成;边缘抗锯齿交给硬件多重采样(MSAA);发光、模糊这些滤镜是显卡上的着色器。底层用的是 wgpu,在 Windows 上走 Vulkan 或 DirectX 12,在 Mac 上走 Metal。
这也解释了开头的问题:分辨率翻 15 倍,对 Flash 来说是 CPU 的活翻了好几倍;对 Ruffle 来说三角形还是那些三角形,CPU 只是写一张"画什么"的命令清单交给显卡,多出来的像素由几千个核心分着画。
一个反直觉的事实:Ruffle 没有 JIT
Ruffle 的 AVM2 目前是解释执行的,单论算逻辑,可能还不如带 JIT 的 Flash 快。
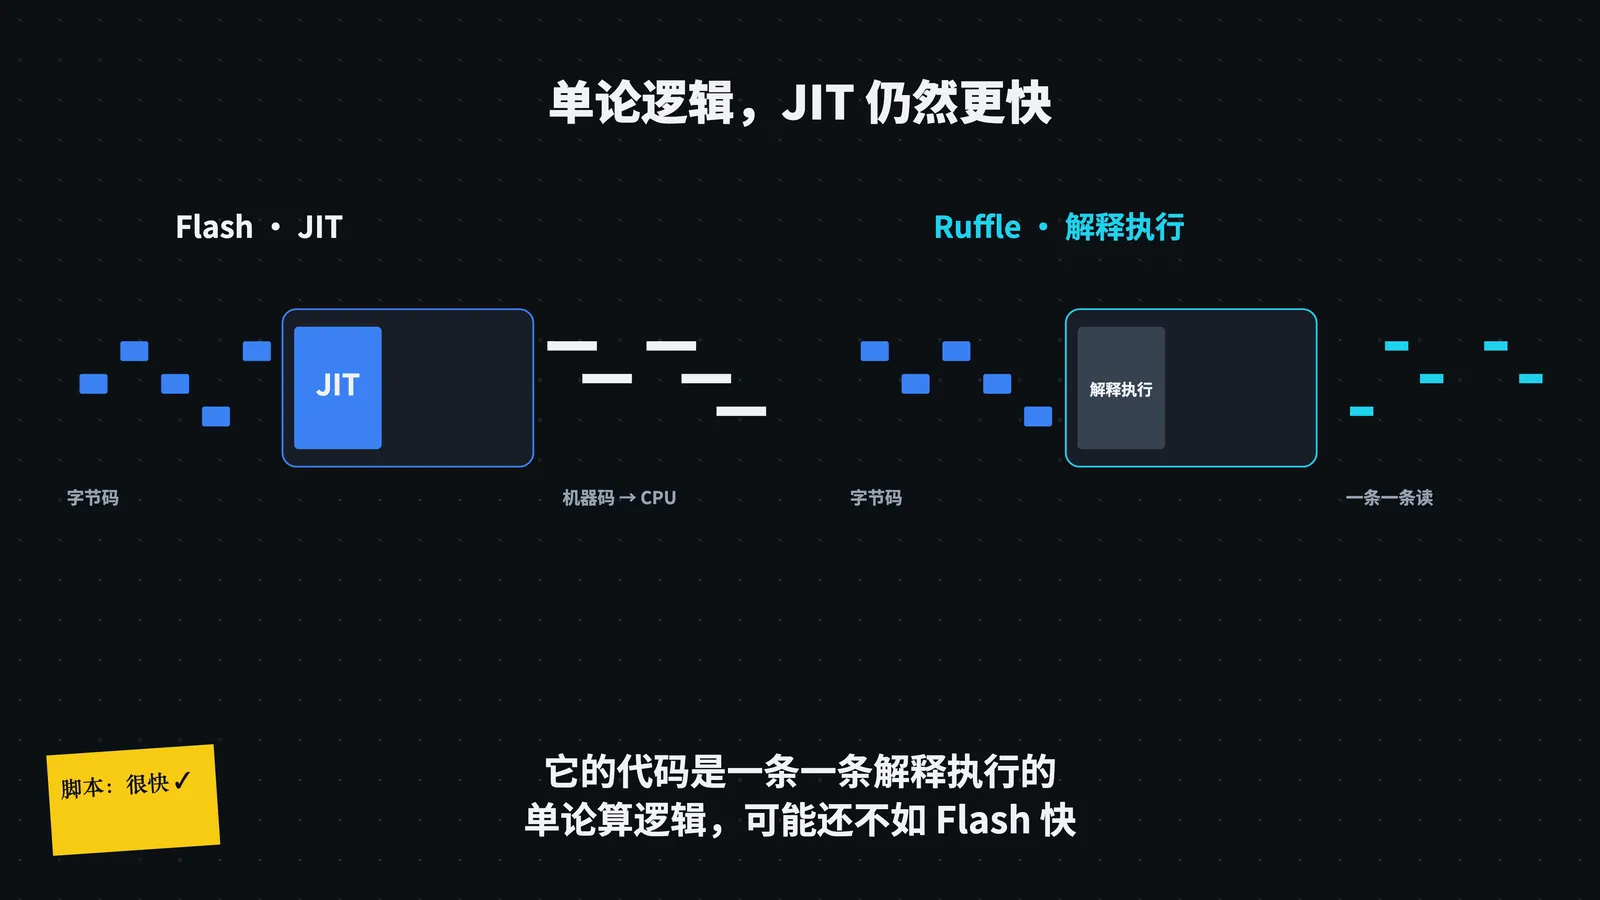
可就是这个算得更慢的播放器,在 4K 下稳稳 60 帧。我自己测过:5 秒钟里,游戏脚本只跑了 0.07 秒左右。这说明 Flash 页游的瓶颈从来不在 JIT、不在算逻辑,而在画画面。
四、让 Ruffle 扛得住一款大型页游
Ruffle 原本更多面对的是网页里的动画和小游戏。直接拿来跑奥奇这种"满屏特效、上千个模块、一玩几个小时"的页游,还是会撞墙。下面是我在 Ruffle 上做的主要改动。
工程上,客户端以固定的 Ruffle 上游提交为基线,所有改动整理成一组按顺序应用的补丁,每片都登记 SHA-256;构建脚本会校验源码树恰好等于"基线 + 补丁序列",拒绝任何未登记的修改。这样 Windows 和 macOS 两端可以逐字节共用同一套运行时,也随时能回答"我们到底改了 Ruffle 什么"。
1. 一颗小火星,不再占一整块屏幕
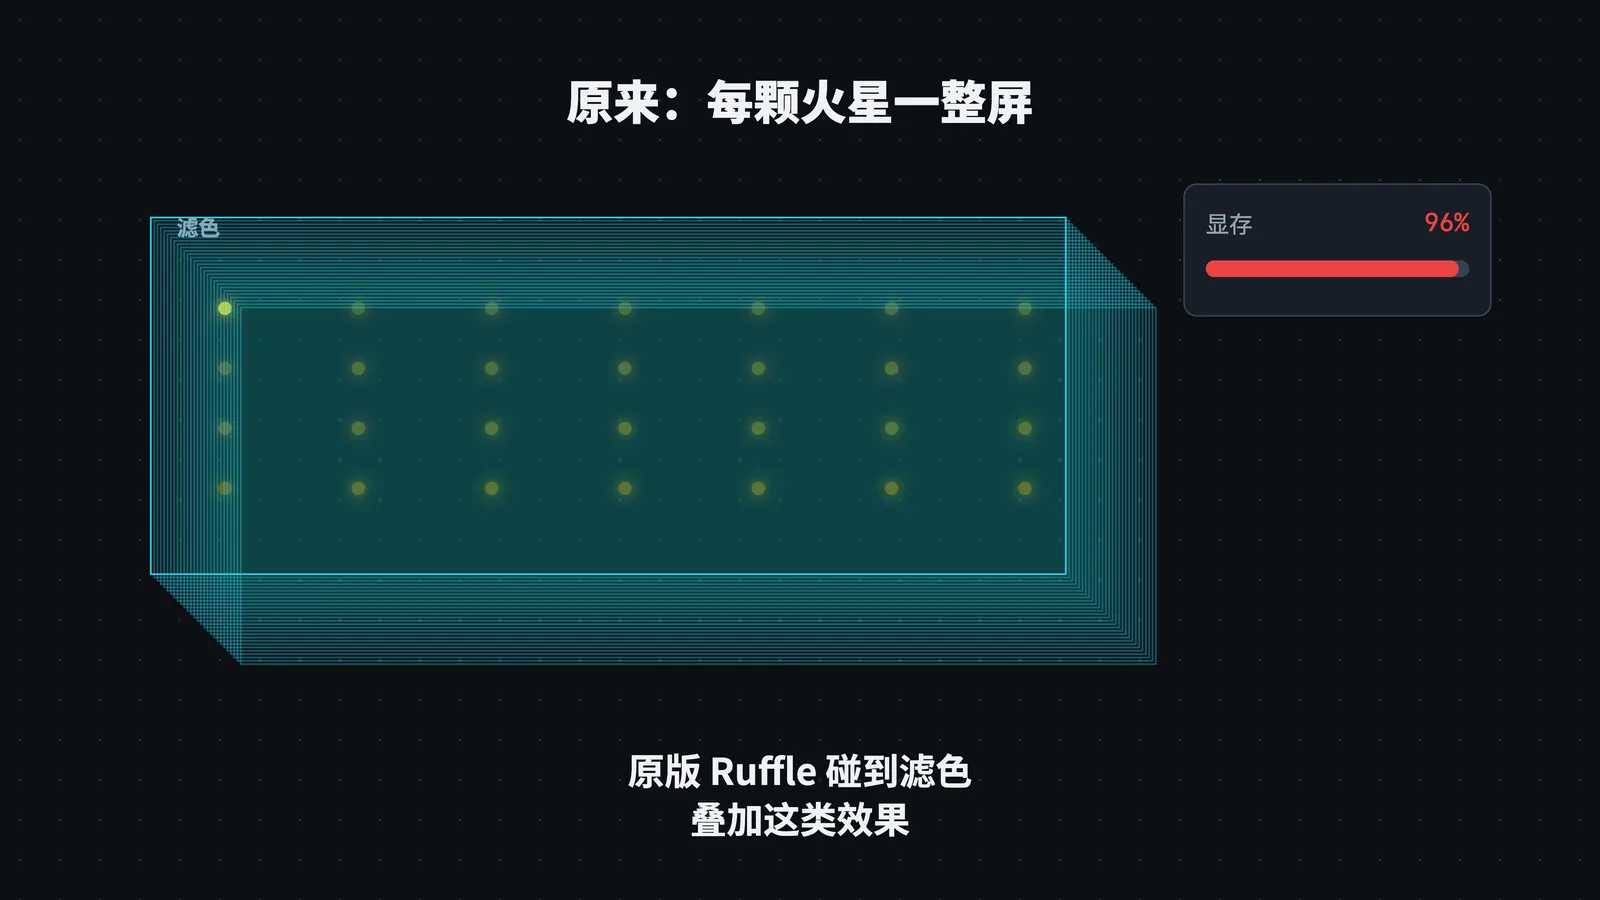
原版 Ruffle 碰到滤色(screen)、叠加(overlay)这类混合模式,会给对象单独开一张和屏幕一样大的离屏画布,哪怕它只有七八个像素。分辨率越高画布越大,满屏粒子时显存直接被打满。
我改成递归计算混合层在设备像素下的真实内容边界(包括描边、位图区域和遮罩几何),外扩 2 像素后按 64/128/256/512 像素分档分配,再平移绘制命令画进去。用完的纹理回到池子里跨帧复用,超过 300 帧没人取用才释放。透视、Stage3D、着色器这类没把握算准边界的情况,仍然回退到整屏画布,并保留整屏/分档两种模式的像素差分测试。
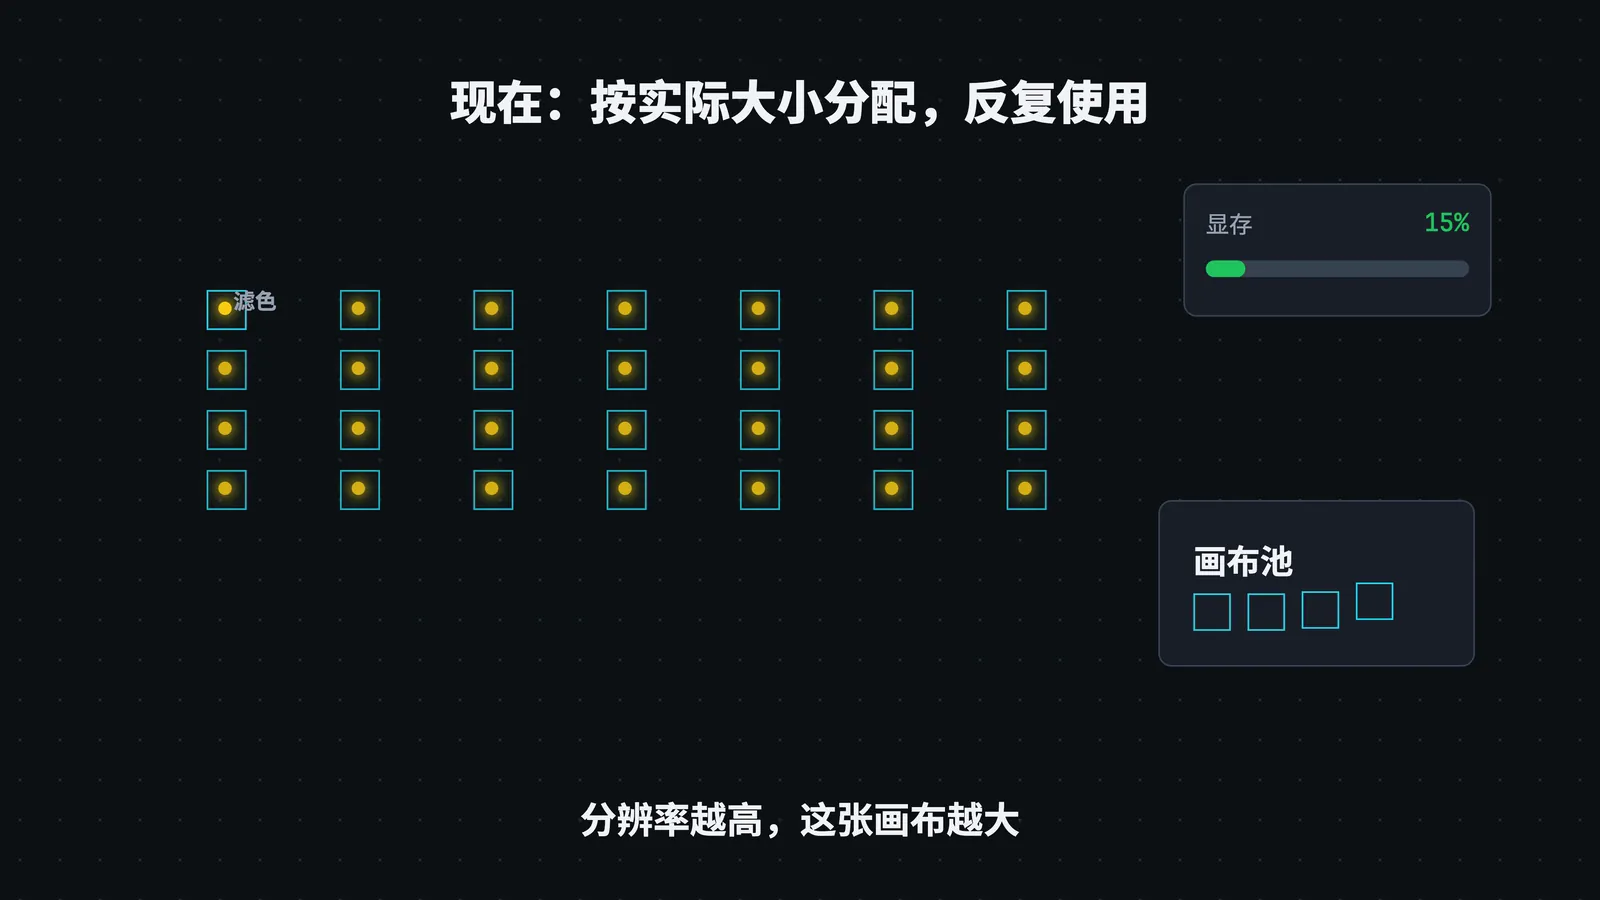
同样的思路也用在了位图缓存和滤镜中间纹理上:动画里边界逐帧变化的对象,不再每帧新建一套缓存纹理、MSAA 和模板缓冲。
2. 舞台外的东西,不再每帧点名
游戏会在舞台外留下几千个用过的影片剪辑,原版每一帧都要挨个推进、检查一遍。现在已经停下来的整片对象会进入休眠,直接跳过,只在它们被重新唤醒时才处理。

3. 加载不再堵住主线程
- 网络读取和资源解压搬到后台线程;
loadBytes改成逐帧预解析,多个加载共享每帧的时间预算,不再一口气把主线程占满; - 加载时有一段很慢的文件校验,原本由脚本逐字节计算,在没有 JIT 的 Ruffle 里每次要几百毫秒。我在
ByteArray上提供了原生的 SHA-256、MD5、Base64,这一段降到一毫秒左右。
4. 根治越玩越卡
这部分是工作量最大的,核心是让"暂时不用的"和"真的没人用的"分别得到正确处理:
- 按需驻留:库里的位图纹理、形状三角化结果、变形帧记录最近使用时间,超出软预算时释放空闲项,下次用到再重建;
- 同样的只存一份:压缩字节相同的影片共享解压数据,同一份库位图共享像素和 GPU 纹理;文本框实例化不再整份克隆模板,排版结果改成不可变共享,改动时才复制;
- 没人用的真正清走:
Dictionary(true)实现真正的弱键;修掉了事件监听、加载记录、AVM1 素材执行表里几处让对象永远被持有的引用链; - 垃圾回收拆到每一帧:Ruffle 用的是增量 GC,我把回收节奏调得更积极(
sleep_factor从 0.25 调到 0.1),让它每帧顺手扫一点,而不是攒到最后全场停工。在 Windows 的固定录像基准上,Rust 堆中位数从 2.86 GB 降到 2.58 GB,帧间隔分布不变。
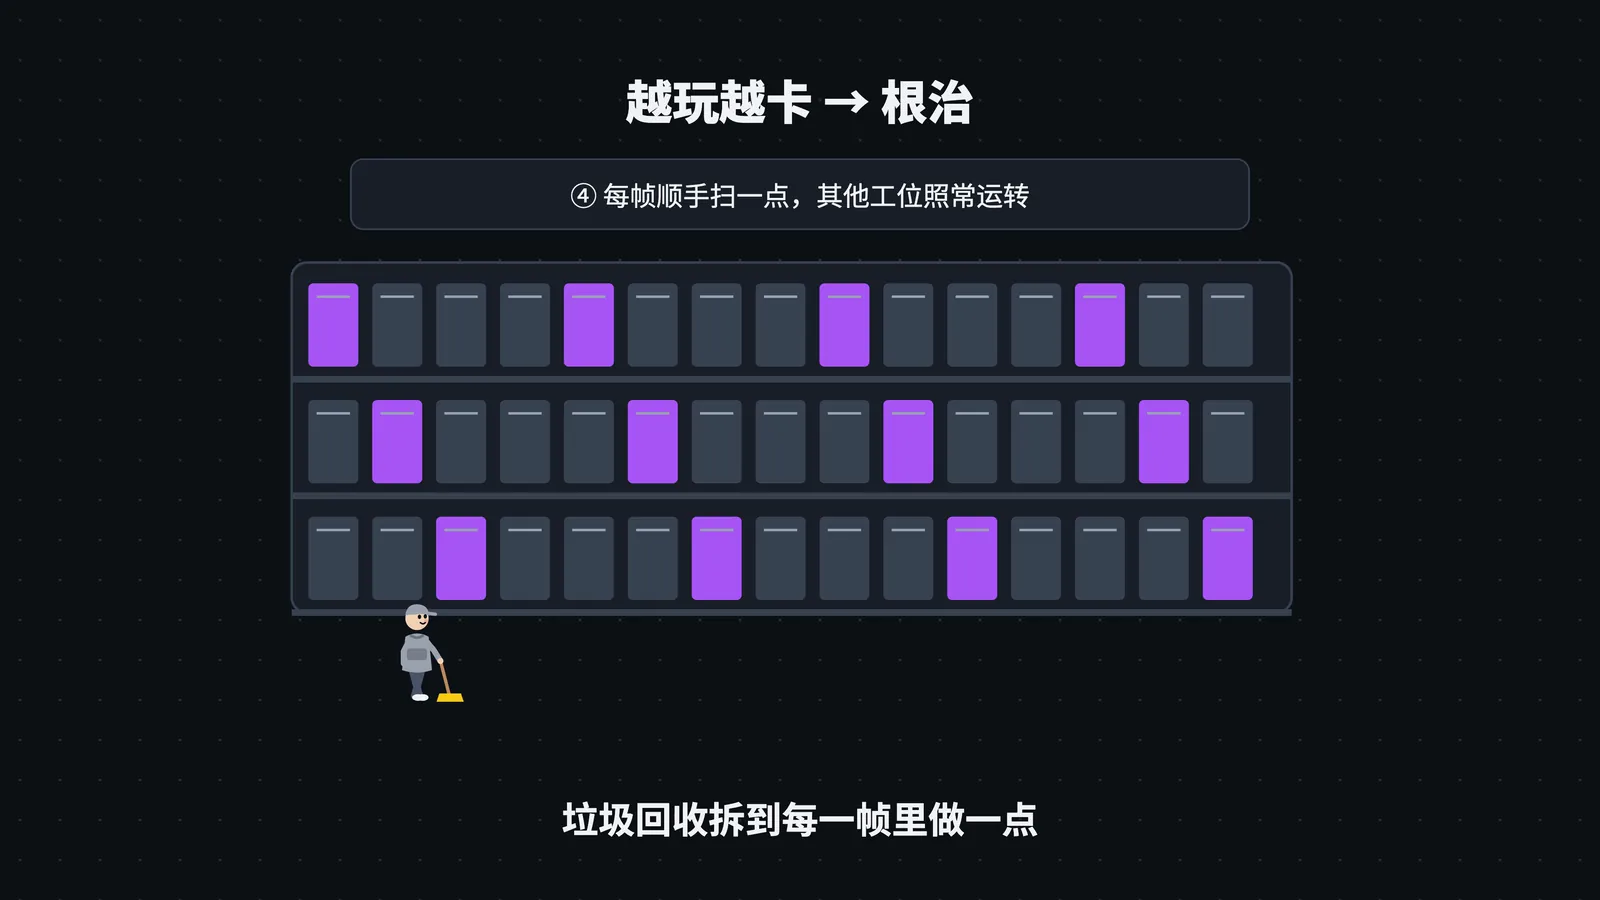
现在打第十场战斗,和打第一场一样流畅。
5. Windows 显卡适配
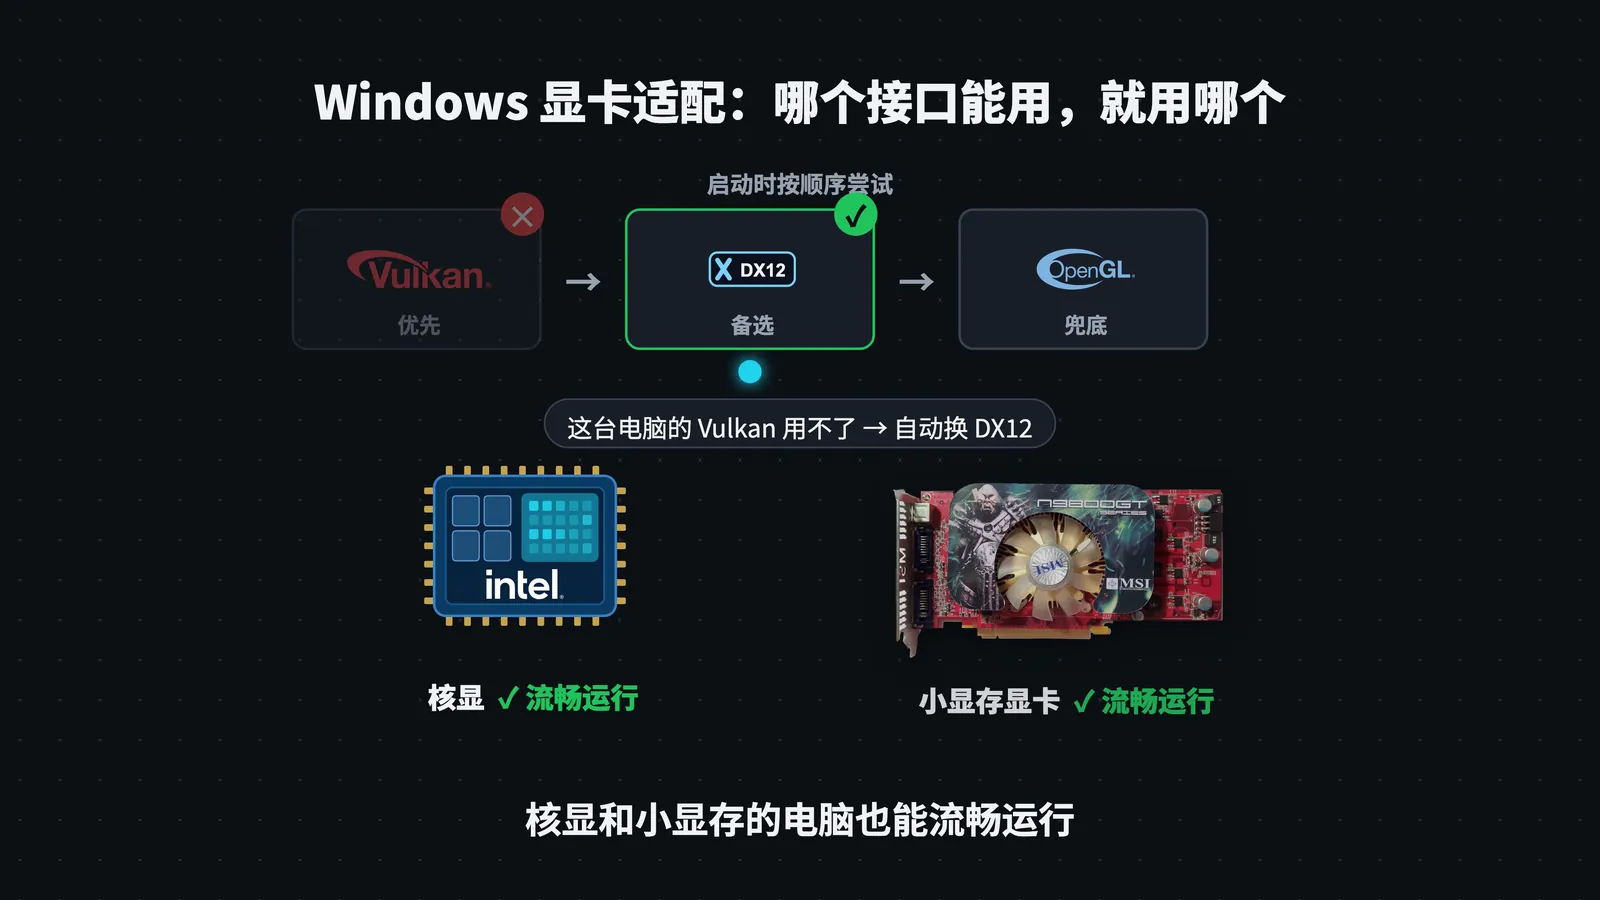
启动时按 Vulkan → DirectX 12 → OpenGL 的顺序尝试,哪个接口出过问题,下次启动就自动换掉。另外两处和显卡相关的小改动:DX12/Vulkan 下小形状的顶点、索引和 uniform 数据打包进共享的 4 MiB 缓冲块,而不是每个形状单独一个最少 64 KiB 的缓冲(实测形状缓冲占用 388–460 MB,实际数据只有 44–71 MB);gpu-allocator 的子分配块从 16 MB 改成 4 MB。核显和小显存的电脑也能流畅运行。
五、换内核不是免费的
讲到这里,得说一句实话:同一台电脑,跑 Flash 时显存几乎不动;换成新客户端,显存多占三四个 G,整机内存也多了大约两个半 G。
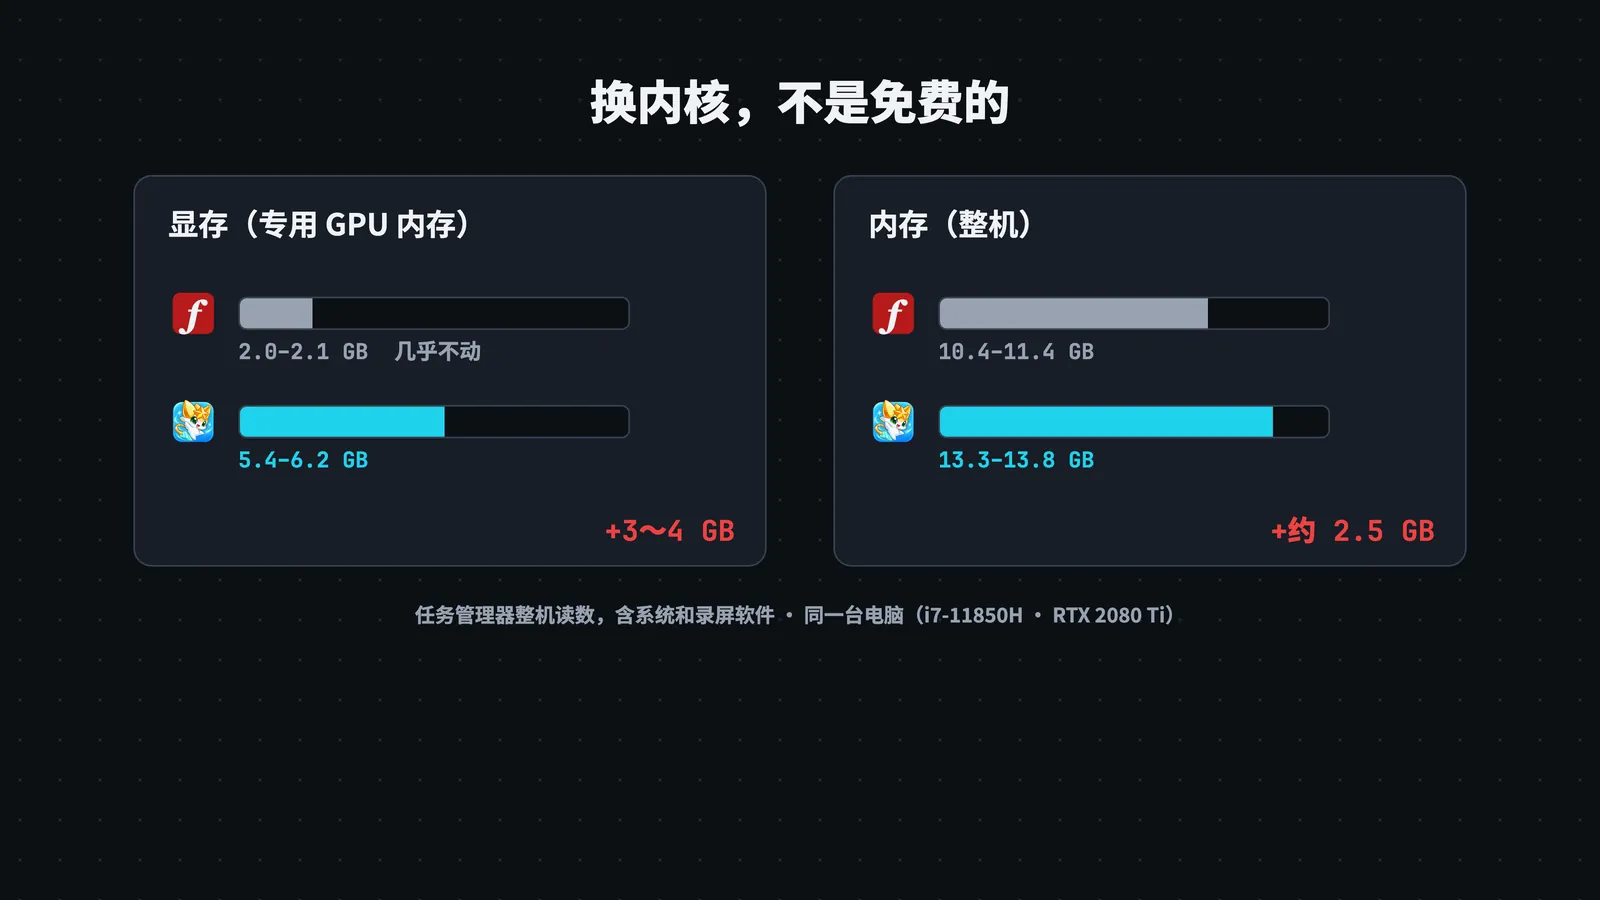
原因有三个:
- 显卡来画,就得先给显卡备料。Flash 用 CPU 画,显卡只负责把画好的一张图显示出来;Ruffle 让显卡画,位图、三角网格、一层层的离屏画布全都要放进显存。高画质还开了 4 倍 MSAA,每个像素存 4 个采样点,一块 1920×1120 的画布从 8.6 MB 变成 34.4 MB。
- 同一份东西存了两遍。显卡用的是显存里那份,CPU 这边的原始数据也还留着:解析好的形状、位图的像素。
- 几百万个脚本对象。奥奇运行时有约 400 万个 AS3 对象交给通用的增量 GC,活着的东西越多,攒着没扫的垃圾也越多。实测一次完整回收能从 1788 MB 降到 1254 MB。
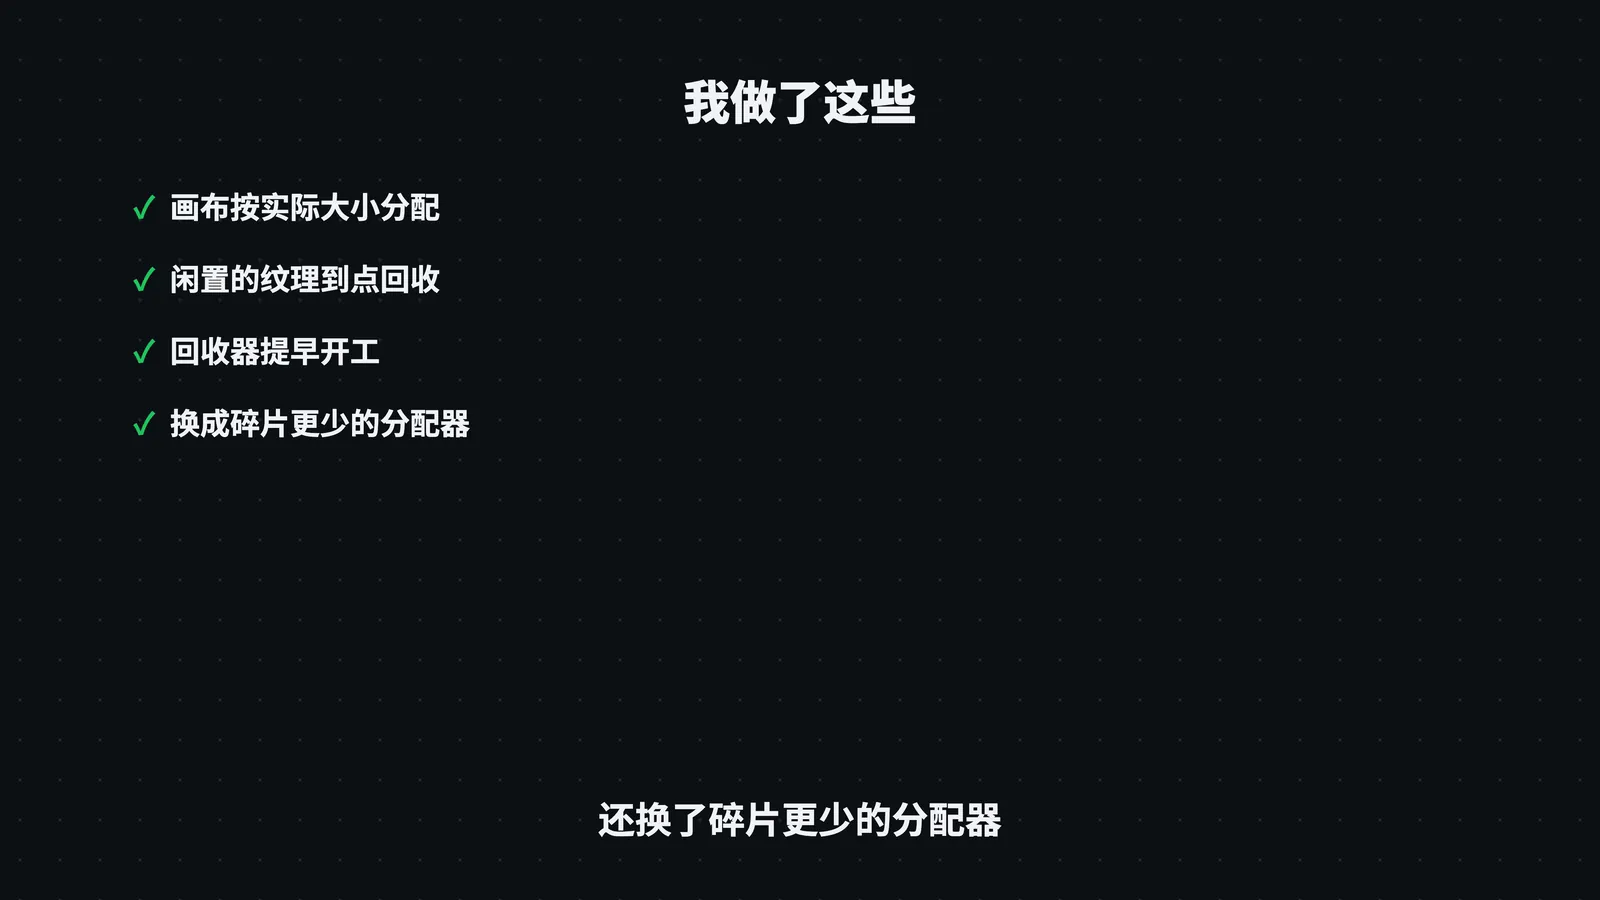
所以上面那些"按实际大小分配画布、闲置纹理到点回收、让回收器提早开工"的改动,很大一部分是在还这笔账。再换上碎片更少的分配器 mimalloc,高画质打一场的进程内存从改之前的 6.6–9.6 GB 降到了 3.8–4.3 GB。
分配器上后来还有一个有意思的发现:资源是在后台线程读进来的,主线程解析完再释放。mimalloc v2 里这些内存块属于分配它的线程,线程闲着就一直回收不了;v3 把满页交出来,任何线程释放后都能回收。macOS 端升级到 v3 后,用 2425 个真实资源文件做的加载对照里,加载结束 2 秒后的内存从约 1280 MB 降到约 990 MB。
但它还是比 Flash 吃得多。说到底,是拿显存和内存换流畅:活儿交给显卡,就得先给显卡备好料。我给自己定的原则是不降画质、不降分辨率、不关抗锯齿,只做结构性的优化。
六、最后
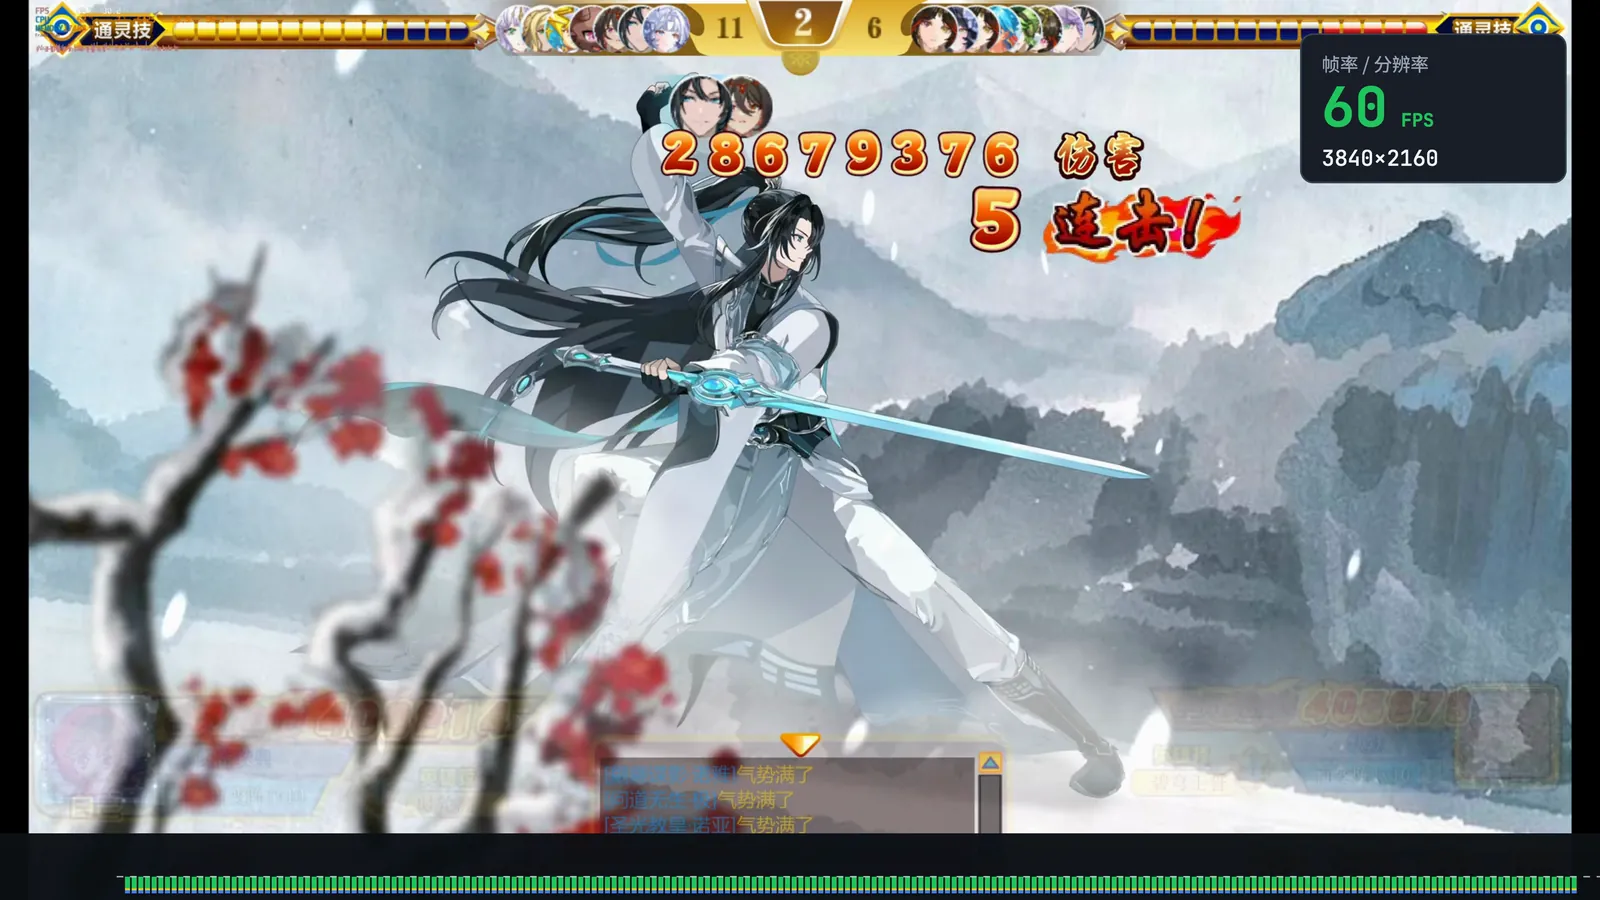
回头看,这件事最有意思的地方在于:一个没有 JIT、算逻辑更慢的播放器,靠着把渲染交给显卡,就让一款十几年前的页游在 4K 下稳定 60 帧。性能优化最重要的一步,永远是先搞清楚时间到底花在了哪里。
特别感谢 Ruffle 开源社区。没有他们把 Flash 一行一行重写出来,就不会有这个客户端。